液相色谱-高分辨质谱(LC-HRMS)具有高质量精度、高灵敏度、高扫描速率等特点,在环境、食品等领域应用广泛[1,2]。近年来LC-HRMS的非靶向分析(NTA)发展迅速[3-5],其中电喷雾电离源(ESI)的应用最为广泛。在LC-ESI-HRMS分析中,由于不同化合物固有的理化性质以及流动相环境等的差异,其电离效率(Ionization Efficiency,IE)的差异可达数个数量级,在缺乏参考标准品的情况下,仅凭峰面积大小来评估非靶向数据中物质的浓度高低,往往会导致误判,进行无参考标准化合物的定量或半定量分析具有实际意义[6-8]。
传统绝对定量分析依赖于参考标准,对目标物构建标准曲线定量[9],在NTA分析中,对于缺乏参考标准的化合物,传统方法为采用结构相似物替代半定量[10,11]、保留时间接近化合物替代半定量[12,13]、平均标准曲线法等[14,15]进行半定量分析。近年来,随着计算化学与机器学习算法等的融合,基于电离效率预测的半定量策略也逐渐发展[16,17]。该策略通过提取已知化合物的分子描述符,利用算法建立分子特征与电离效率之间的数学模型,提取无参考标准化合物的分子描述符,从而预测其电离效率,进而由峰面积和电离效率进行化合物浓度的定量估算。Aalizadeh等[18]采用支持向量机和人工神经网络算法建立电离效率预测模型,并将其应用于海水样品中化合物的定量预测。Feng等[19]采用多元线性回归建立了塑化剂代谢物的定量结构-响应关系模型,用于尿液样品中无参考标准的增塑剂代谢物的定量预测。
尽管基于机器学习的电离效率预测在非靶向定量中展现出巨大潜力,但目前相关研究仍相对较少,且现有的预测模型在特征选择和电离机制解释方面存在一定的局限性。本研究立足于机制探索与模型构建的结合,以多类代表性小分子有机物为研究对象,在ESI正离子模式下构建并优选出预测模型;进一步引入SHAP全局可解释性分析框架,研究电离效率差异的关键影响因素;将模型应用于实际水样中化合物的定量分析,为NTA分析中无参考标准化合物的定量提供方法支撑。
1 实验部分
1.1 主要仪器与试剂
Vanquish型高效液相色谱仪串联Q Exactive plus静电场轨道阱高分辨质谱仪(美国Thermo Fisher Scientific公司);Milli-Q型超纯水仪(德国Merck公司);ME614S型电子天平(德国Sartorius公司);CR21GⅢ型离心机(日本Hitachi公司);KS260型振荡摇床(德国IKA公司);N-EVAP 111型氮吹仪(美国Organomation Associates公司);微孔过滤膜(水系,0.45 μm,天津市津腾实验设备有限公司)。
小分子有机化合物共37种,包括有机磷化合物、个人护理与药物用品、环境/包装有害污染物、农药、食品添加剂等不同类别,具体信息见表1。D5-恩诺沙星同位素内标(99%,同位素丰度 >99.0%,德国Witega公司);甲醇(色谱级,德国Merck公司);醋酸铵(色谱级,德国Sigma公司);OASIS HLB固相萃取柱(6 mL,150 mg,美国 Waters公司)。
表1 化合物信息
Tab.1 Compound information
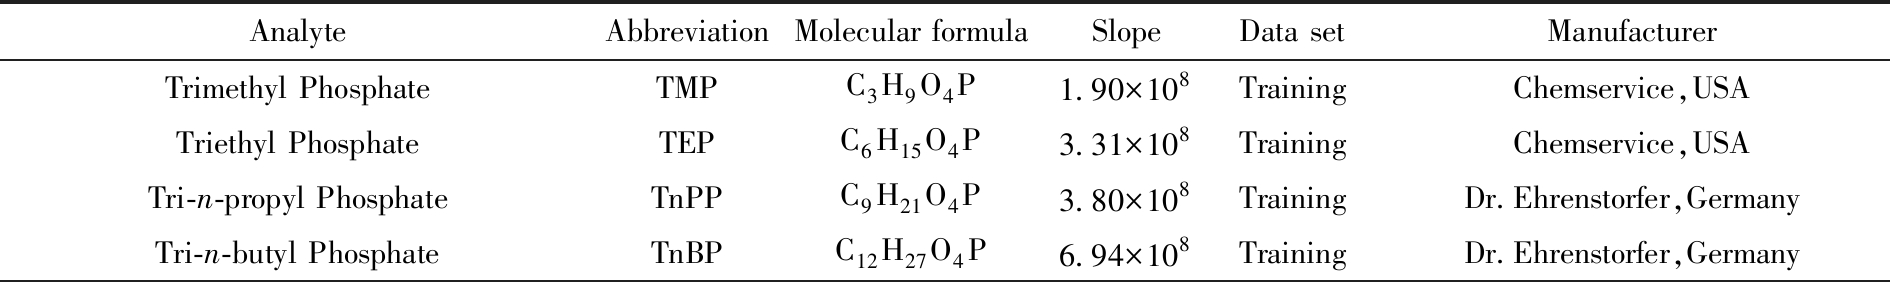
AnalyteAbbreviationMolecular formulaSlopeData setManufacturerTrimethyl PhosphateTMPC3H9O4P1.90×108TrainingChemservice,USATriethyl PhosphateTEPC6H15O4P3.31×108TrainingChemservice,USATri-n-propyl PhosphateTnPPC9H21O4P3.80×108TrainingDr.Ehrenstorfer,GermanyTri-n-butyl PhosphateTnBPC12H27O4P6.94×108TrainingDr.Ehrenstorfer,Germany
续表
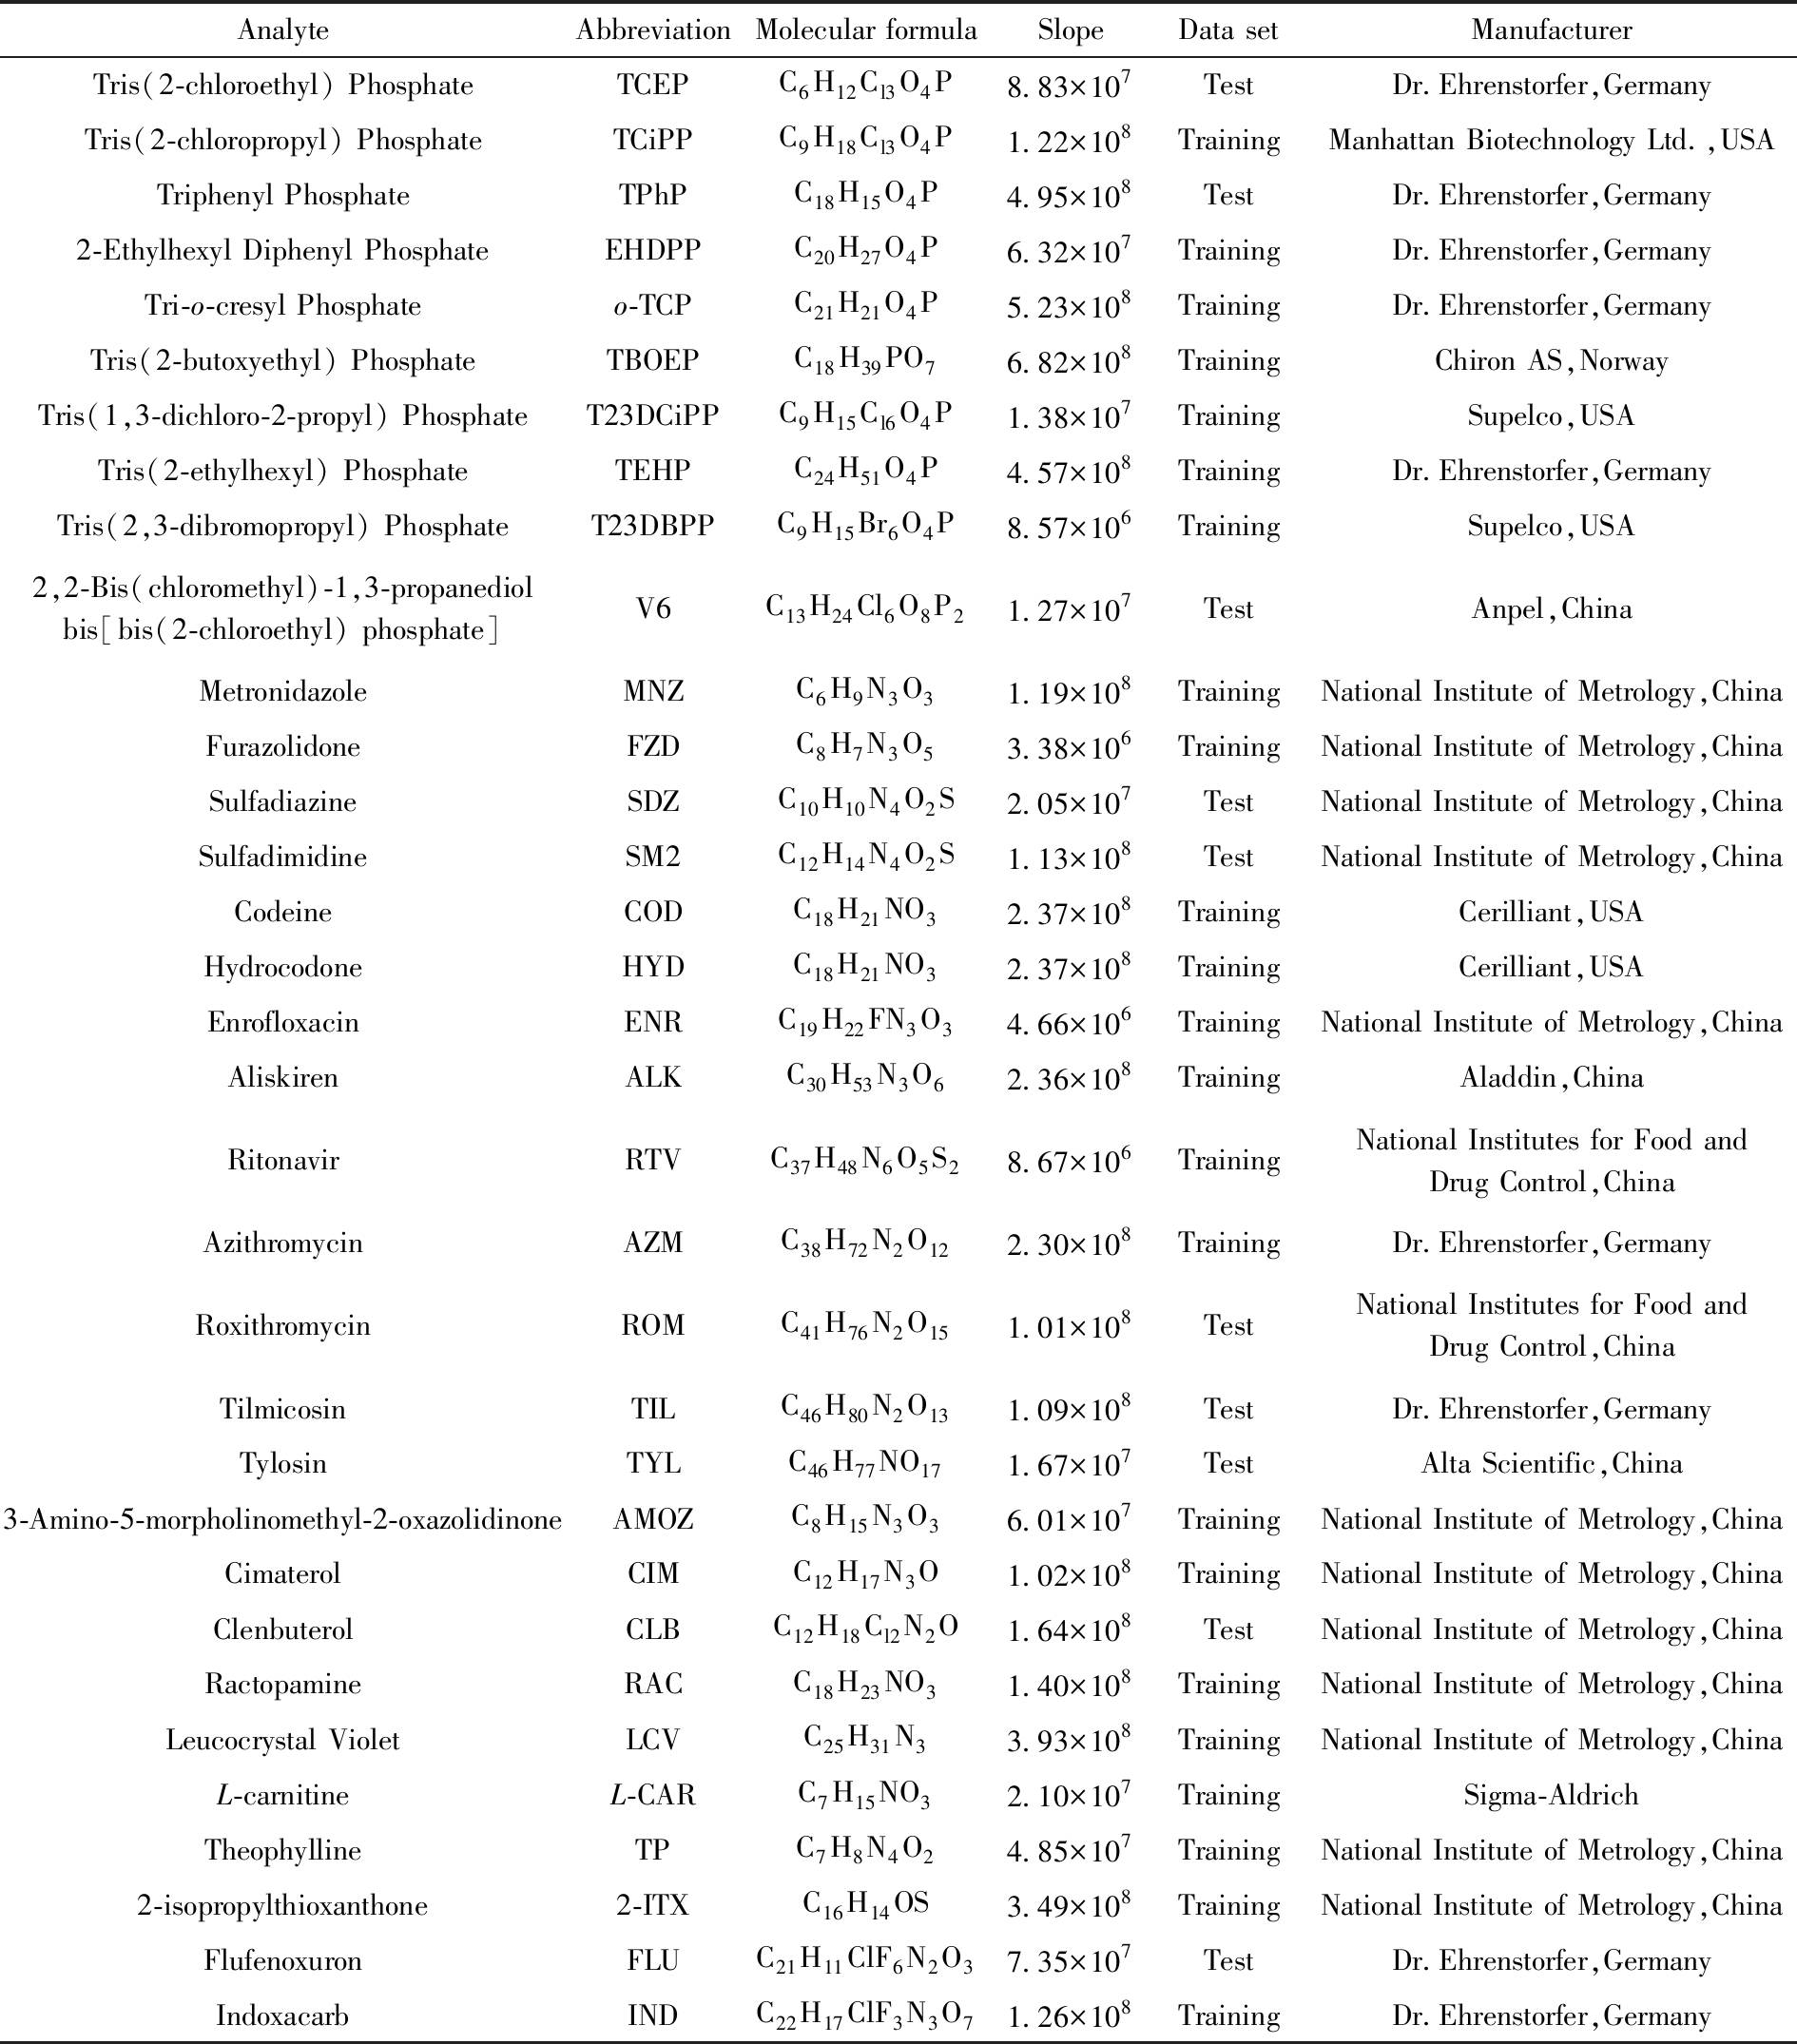
AnalyteAbbreviationMolecular formulaSlopeData setManufacturerTris(2-chloroethyl) PhosphateTCEPC6H12Cl3O4P8.83×107TestDr.Ehrenstorfer,GermanyTris(2-chloropropyl) PhosphateTCiPPC9H18Cl3O4P1.22×108TrainingManhattan Biotechnology Ltd.,USATriphenyl PhosphateTPhPC18H15O4P4.95×108TestDr.Ehrenstorfer,Germany2-Ethylhexyl Diphenyl PhosphateEHDPPC20H27O4P6.32×107TrainingDr.Ehrenstorfer,GermanyTri-o-cresyl Phosphateo-TCPC21H21O4P5.23×108TrainingDr.Ehrenstorfer,GermanyTris(2-butoxyethyl) PhosphateTBOEPC18H39PO76.82×108TrainingChiron AS,NorwayTris(1,3-dichloro-2-propyl) PhosphateT23DCiPPC9H15Cl6O4P1.38×107TrainingSupelco,USATris(2-ethylhexyl) PhosphateTEHPC24H51O4P4.57×108TrainingDr.Ehrenstorfer,GermanyTris(2,3-dibromopropyl) PhosphateT23DBPPC9H15Br6O4P8.57×106TrainingSupelco,USA2,2-Bis(chloromethyl)-1,3-propanediol bis[bis(2-chloroethyl) phosphate]V6C13H24Cl6O8P21.27×107TestAnpel,ChinaMetronidazoleMNZC6H9N3O31.19×108TrainingNational Institute of Metrology,ChinaFurazolidoneFZDC8H7N3O53.38×106TrainingNational Institute of Metrology,ChinaSulfadiazineSDZC10H10N4O2S2.05×107TestNational Institute of Metrology,ChinaSulfadimidineSM2C12H14N4O2S1.13×108TestNational Institute of Metrology,ChinaCodeineCODC18H21NO32.37×108TrainingCerilliant,USAHydrocodoneHYDC18H21NO32.37×108TrainingCerilliant,USAEnrofloxacinENRC19H22FN3O34.66×106TrainingNational Institute of Metrology,ChinaAliskirenALKC30H53N3O62.36×108TrainingAladdin,ChinaRitonavirRTVC37H48N6O5S28.67×106TrainingNational Institutes for Food and Drug Control,ChinaAzithromycinAZMC38H72N2O122.30×108TrainingDr.Ehrenstorfer,GermanyRoxithromycinROMC41H76N2O151.01×108TestNational Institutes for Food and Drug Control,ChinaTilmicosinTILC46H80N2O131.09×108TestDr.Ehrenstorfer,GermanyTylosinTYLC46H77NO171.67×107TestAlta Scientific,China3-Amino-5-morpholinomethyl-2-oxazolidinoneAMOZC8H15N3O36.01×107TrainingNational Institute of Metrology,ChinaCimaterolCIMC12H17N3O1.02×108TrainingNational Institute of Metrology,ChinaClenbuterolCLBC12H18Cl2N2O1.64×108TestNational Institute of Metrology,ChinaRactopamineRACC18H23NO31.40×108TrainingNational Institute of Metrology,ChinaLeucocrystal VioletLCVC25H31N33.93×108TrainingNational Institute of Metrology,ChinaL-carnitineL-CARC7H15NO32.10×107TrainingSigma-AldrichTheophyllineTPC7H8N4O24.85×107TrainingNational Institute of Metrology,China2-isopropylthioxanthone2-ITXC16H14OS3.49×108TrainingNational Institute of Metrology,ChinaFlufenoxuronFLUC21H11ClF6N2O37.35×107TestDr.Ehrenstorfer,GermanyIndoxacarbINDC22H17ClF3N3O71.26×108TrainingDr.Ehrenstorfer,Germany
1.2 水样采集及前处理方法
环境地表水于2025年10月使用1 L棕色玻璃瓶采集,4 ℃冷藏避光运输至实验室后立即进行样品前处理。取400 mL水样经0.45 μm微孔过滤膜过滤,加入恩诺沙星内标溶液混合均匀。HLB固相萃取柱经6 mL甲醇、6 mL水活化后上样,6 mL 5%甲醇水淋洗,弃去淋洗液,抽干,8 mL甲醇洗脱,收集洗脱液,40 ℃水浴氮吹浓缩至近干,采用初始流动相复溶至1 mL,14000 r/min高速离心10 min,上清液转移至棕色进样瓶中待测。
1.3 LC-HRMS仪器分析方法
采用Acquity UPLC BEH C18色谱柱(100 mm×2.1 mm,1.7 μm,美国Waters公司);流动相A相为含5 mmol/L醋酸铵的V(甲醇)∶V(水)=1∶9混合溶液,B相为含5 mmol/L醋酸铵的甲醇溶液;流速0.2 mL/min;色谱柱温度40 ℃;样品温度 10 ℃;进样体积:5 μL。梯度洗脱程序:0~1 min,99% A,1~5 min,99% A~61% A;5~21 min,61% A~1% A;21~25 min,1% A;25~25.1 min,1% A~99% A;25.1~30 min,99% A。
高分辨质谱采用电喷雾离子源,在正离子模式下进行分析。离子源参数设置如下:喷雾电压设置为3 kV,离子传输管温度设置为350 ℃,鞘气流速设置为40 arb,辅助气流速设置为10 arb,辅助气加热温度设置为320 ℃,吹扫气流速设置为2 arb。数据采集采用全扫描-数据依赖的二级质谱扫描模式(Full MS-ddMS2)。其中,一级质谱的分辨率设置为70000,m/z扫描范围设置为80~1200;二级质谱的扫描分辨率设置为35000,复合碰撞能分别设置为10、30和70 eV。
1.4 模型建立与评估
1.4.1 电离效率获取与数据预处理
37种化合物以甲醇为溶剂配制12个浓度梯度的系列混合溶液,浓度范围为1~380 ng/mL。采用全扫描的峰面积数据绘制校准曲线,得到校准曲线斜率(Slope,表1),所有化合物的加合离子均为[M+H]+。并且引入分子量转化为物质的量浓度,由公式(1)计算实验相对电离效率(Exp.log IE)。
Exp.log IE=log10[(slope化合物/slope校准化合物)×
(MW校准化合物/MW化合物)]
(1)
式中,Exp.log IE为目标化合物的实验相对电离效率,slope化合物和slope校准化合物为目标化合物和校准化合物的斜率,MW化合物和MW校准化合物为目标化合物和校准化合物的相对分子质量。
本研究选择TEHP作为校准化合物,该化合物具有良好的灵敏度、重复性和电离稳定性。对于没有参考标准的化合物,利用全扫描峰面积(PeakArea化合物)和基于电离效率模型的预测电离效率(Pred.log IE)在实际样品中进行定量预测,得到预测的化合物浓度(Pred.conc)如公式(2)所示。
Pred.conc.=(PeakArea化合物×MW校准化合物)/
([10Pred.log IE]slope校准化合物MW化合物)
(2)
1.4.2 模型建立
将37种化合物的数据集按3∶1比例随机划分为训练集和测试集。采用经特征选择的分子描述符作为模型输入特征变量,公式(1)计算得到的Exp.log IE作为模型输出响应变量,比较不同机器学习算法,建立电离效率预测模型。模型构建基于Python语言,在Jupyter Notebook交互式运行环境下编程实现。
1.4.3 电离效率预测模型评价与验证
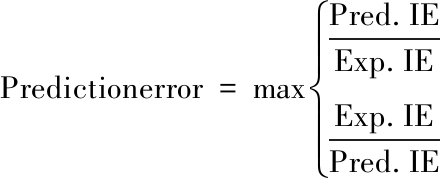
(3)
式中,Predictionerror为预测误差,Pred.IE为预测的电离效率,Exp.IE为实验电离效率。
采用决定系数(R2)、均方根误差(RMSE)、交叉验证决定系数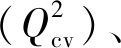 一致性相关系数(CCC)以及外部验证指标对模型性能进行综合评价,采用外部预测能力指标
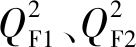 和
 对模型泛化能力进行评价[20]。
2 结果与讨论
2.1 特征选择
本研究采用PaDEL-Descriptor计算1444个初始2D分子描述符。经预处理剔除常量描述符后,基于Pearson相关系数开展特征冗余筛选。特征相关性阈值的选取会直接影响特征筛选结果与最终模型性能,阈值设定过低易过度剔除有效特征,造成关键建模信息丢失;阈值设定过高则会保留大量高度相关的冗余描述符,提升模型复杂度的同时,易引发信息重叠、解释性冗余等问题[21]。本研究选取0.8作为高冗余描述符的剔除标准,剔除Pearson相关系数>0.8的高冗余参数后,剩余180个分子描述符。进一步结合交叉验证的递归特征消除(RFE)筛选出11个关键描述符。如图1所示,描述符数量为11时,均方根误差最小。
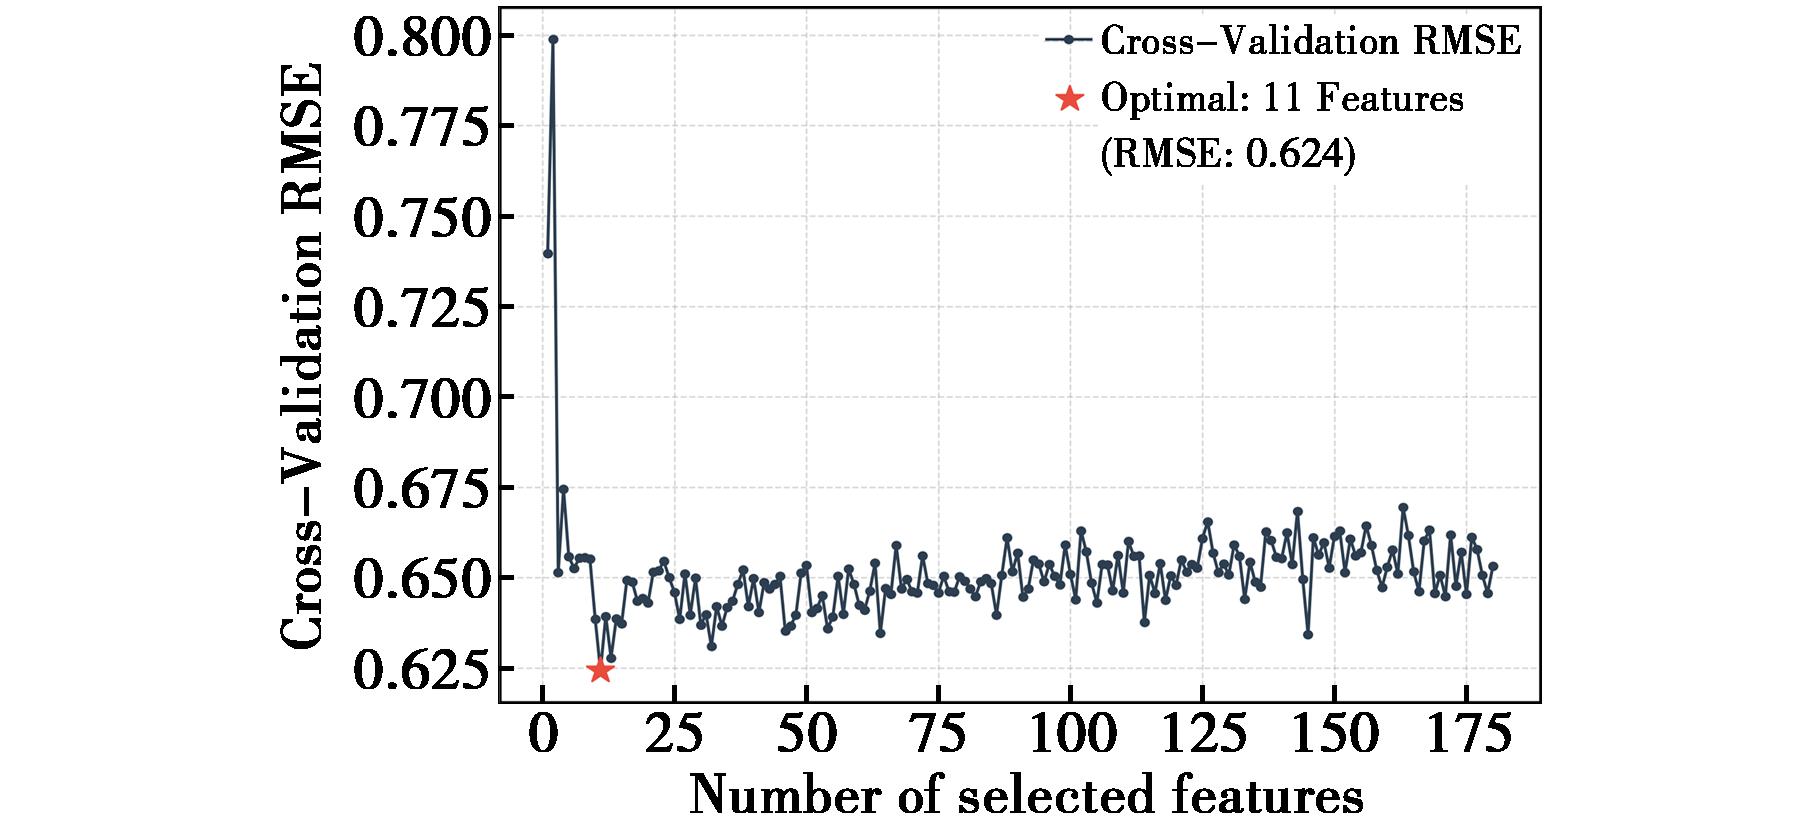
图1 递归特征消除算法结合交叉验证筛选描述符
Fig.1 Descriptor selection using recursive feature elimination with cross-validation
为了验证所选描述符的独立性并排除多重共线性对模型解释的干扰,计算11个关键特征间的Pearson相关系数(图2a),所有特征对的相关系数绝对值均被严格控制在0.8的阈值以下,为模型建立提供了丰富、非冗余且高质量的特征空间。为了阐明各分子描述符对log IE预测的具体贡献及其作用方向,构建了方向性特征重要性图(图2b)。分析结果表明,MIC1在所有描述符中占据主导地位,且呈现出显著的负向驱动效应。MIC1为一阶邻域对称性修正信息含量指数,用于表征分子的局部拓扑对称性,该结果表明,分子的局部拓扑对称性是影响log IE的重要因素,随着分子局部结构复杂性升高,其log IE倾向于显著降低。SpMax2_Bhs、AATS8e、ALogp2、nBondsD、ATSC4c、VE1_Dzv、AMR数描述符同样表现出对log IE的负向抑制作用,反映出分子电性分布均匀性、疏水性、共轭程度、分子尺寸及拓扑规整性等特征整体上不利于电荷局域化与电离过程发生。值得注意的是,ATSC7p和ATSC3m是所选特征中仅有的两个正向驱动因素,分别代表极化率加权与质量加权的拓扑结构特征,表明局部原子极化率与质量分布的非均一性有利于提升电离效率。这种以负向抑制为主、正向促进为辅的多维特征组合表明,log IE的变化并非受单一机制控制,而是分子内部多种拓扑、几何及物理化学属性相互拮抗与协同作用的综合结果。
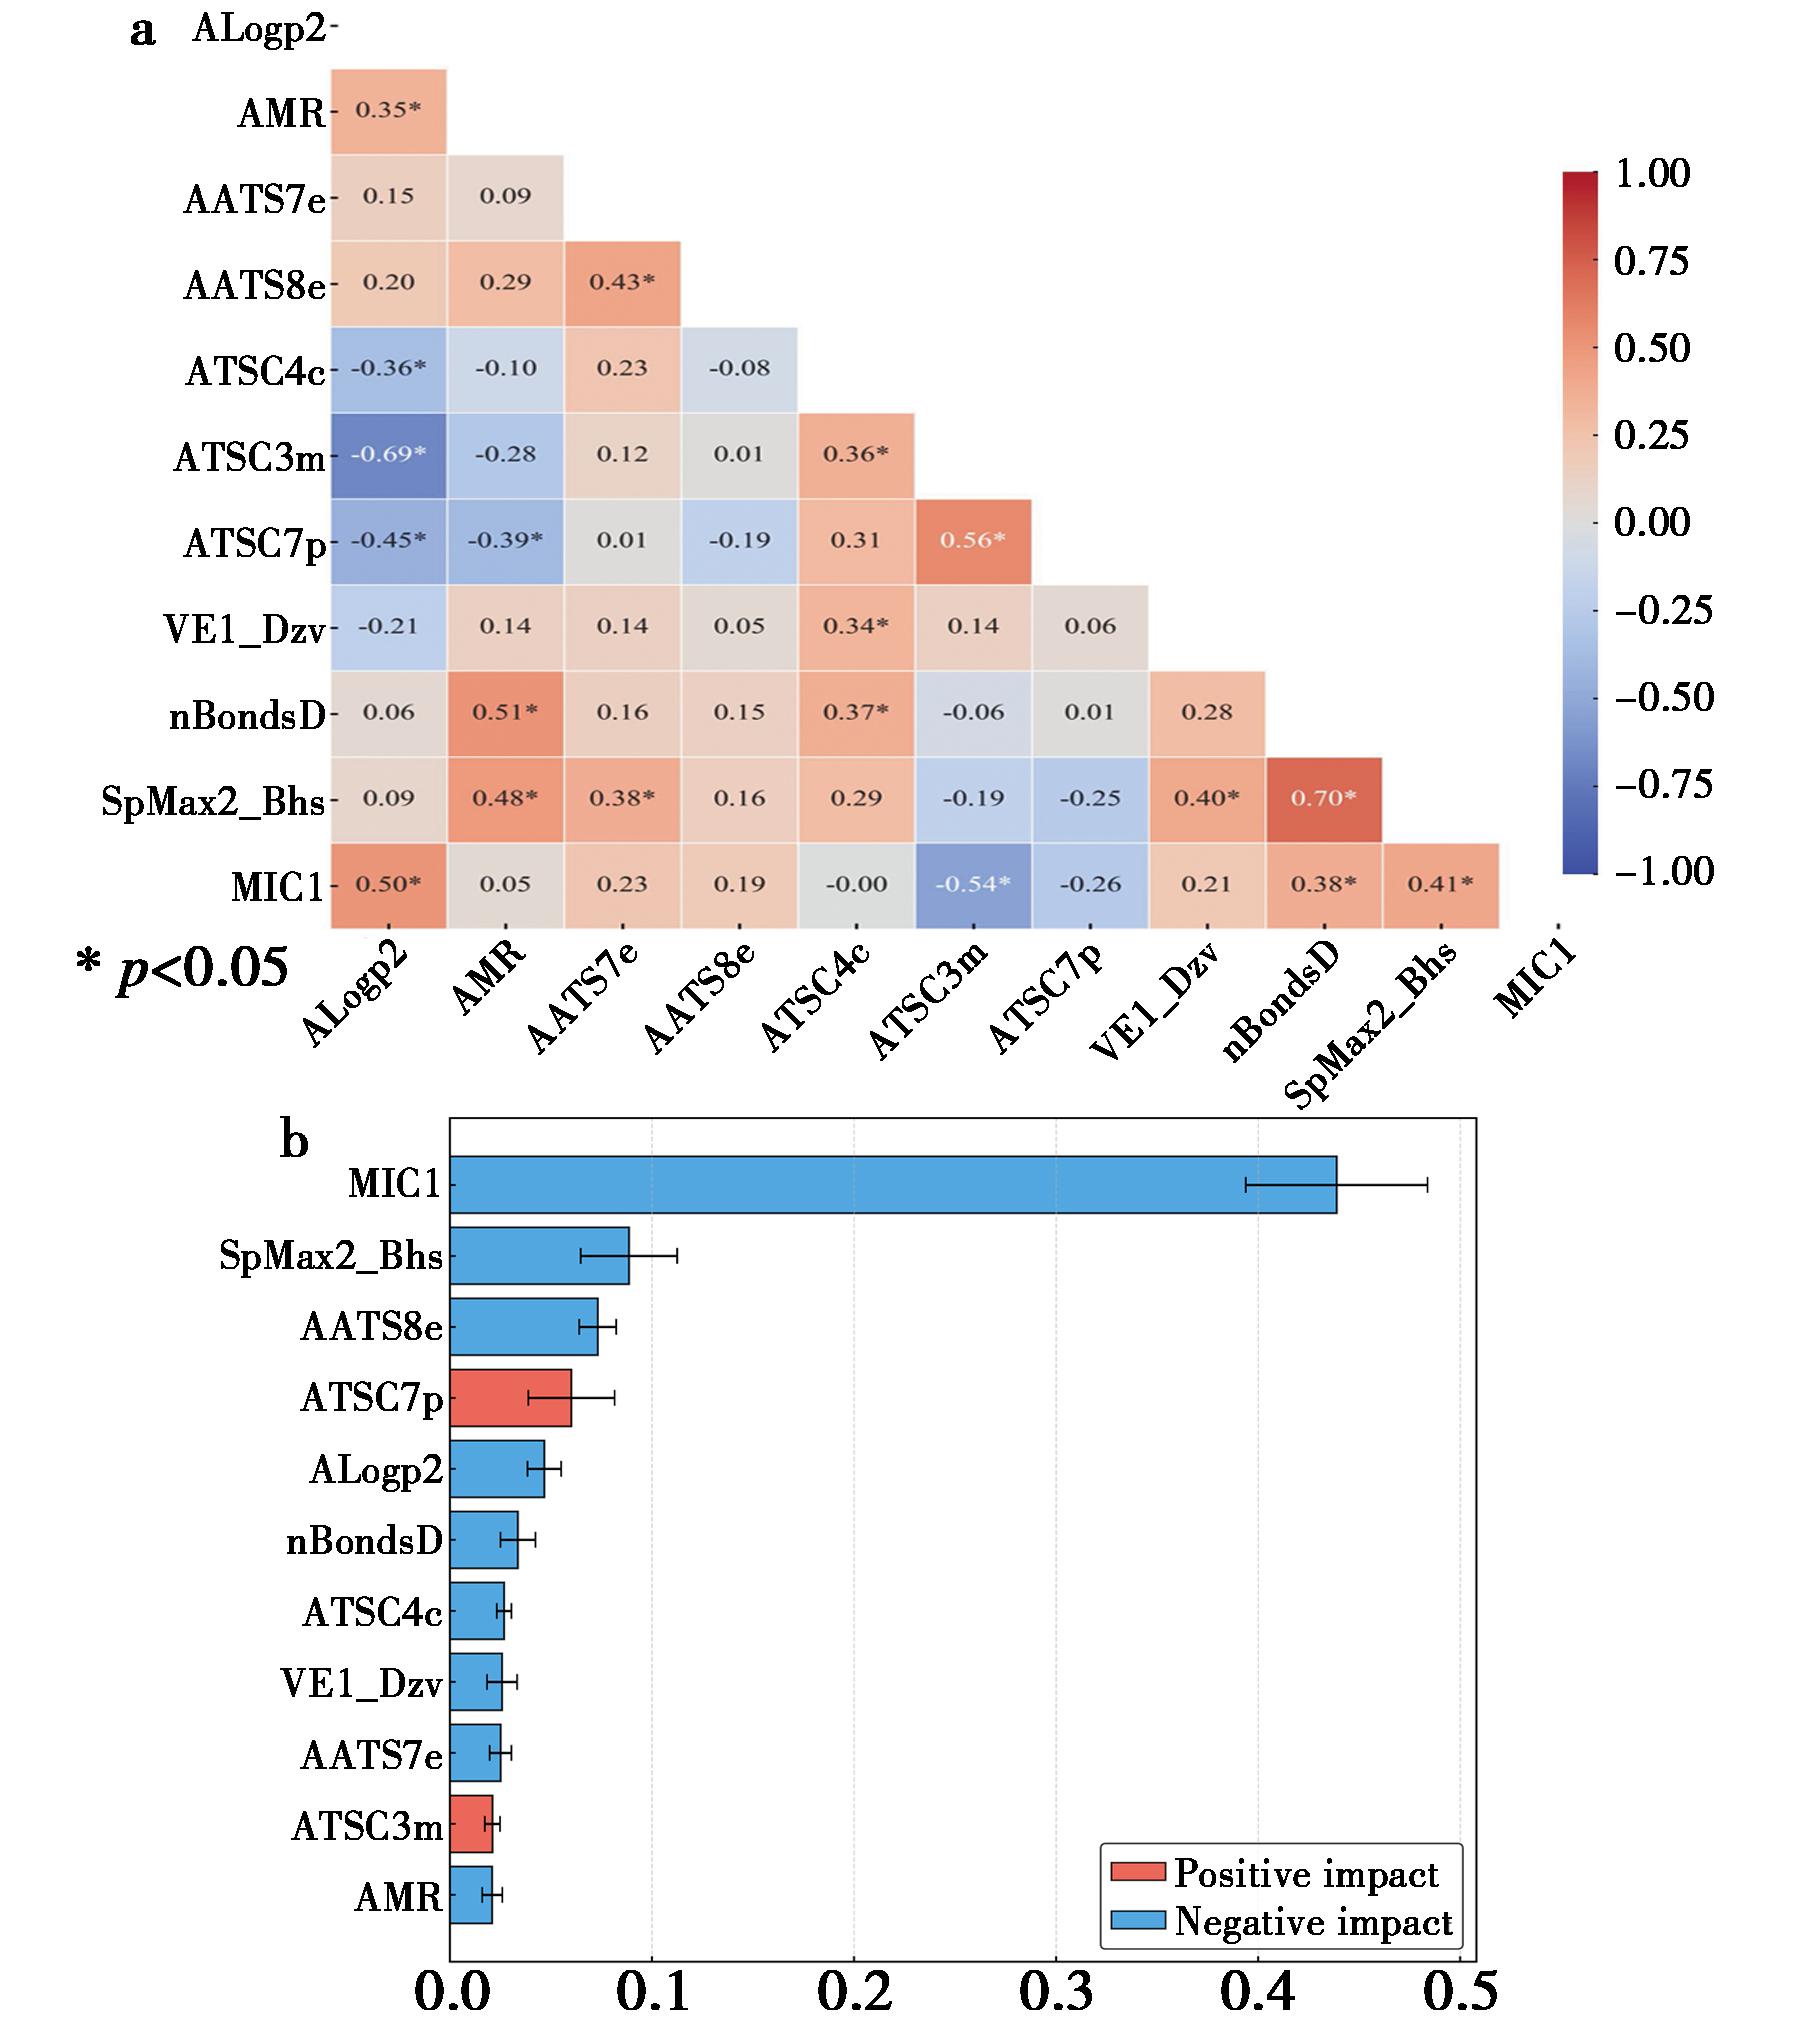
a.特征之间热力图;b.方向性特征重要性图
图2 特征重要性及相关性
Fig.2 Feature importance and feature correlations
2.2 机器学习算法比较
为了筛选出能够准确预测化合物log IE的最佳模型,本研究系统性地评估了5种机器学习算法:多元线性回归(MLR)、K近邻(KNN)、支持向量回归(SVR)、梯度提升回归(GBR)以及随机森林(RF)(图3)。这5种算法在原理和适用性上各有侧重,MLR假设分子描述符与电离效率呈线性关系,模型简单且可解释性强,但对非线性问题处理能力有限;KNN通过寻找特征空间中最近的K个样本进行预测,依赖相似度度量;SVR通过核函数将数据映射至高维特征空间,并在此空间中寻找最平坦的回归函数;GBR采用迭代策略,通过不断拟合前一轮迭代的残差来优化模型;RF则通过集成大量随机生成的决策树并对预测结果取平均来进行建模。
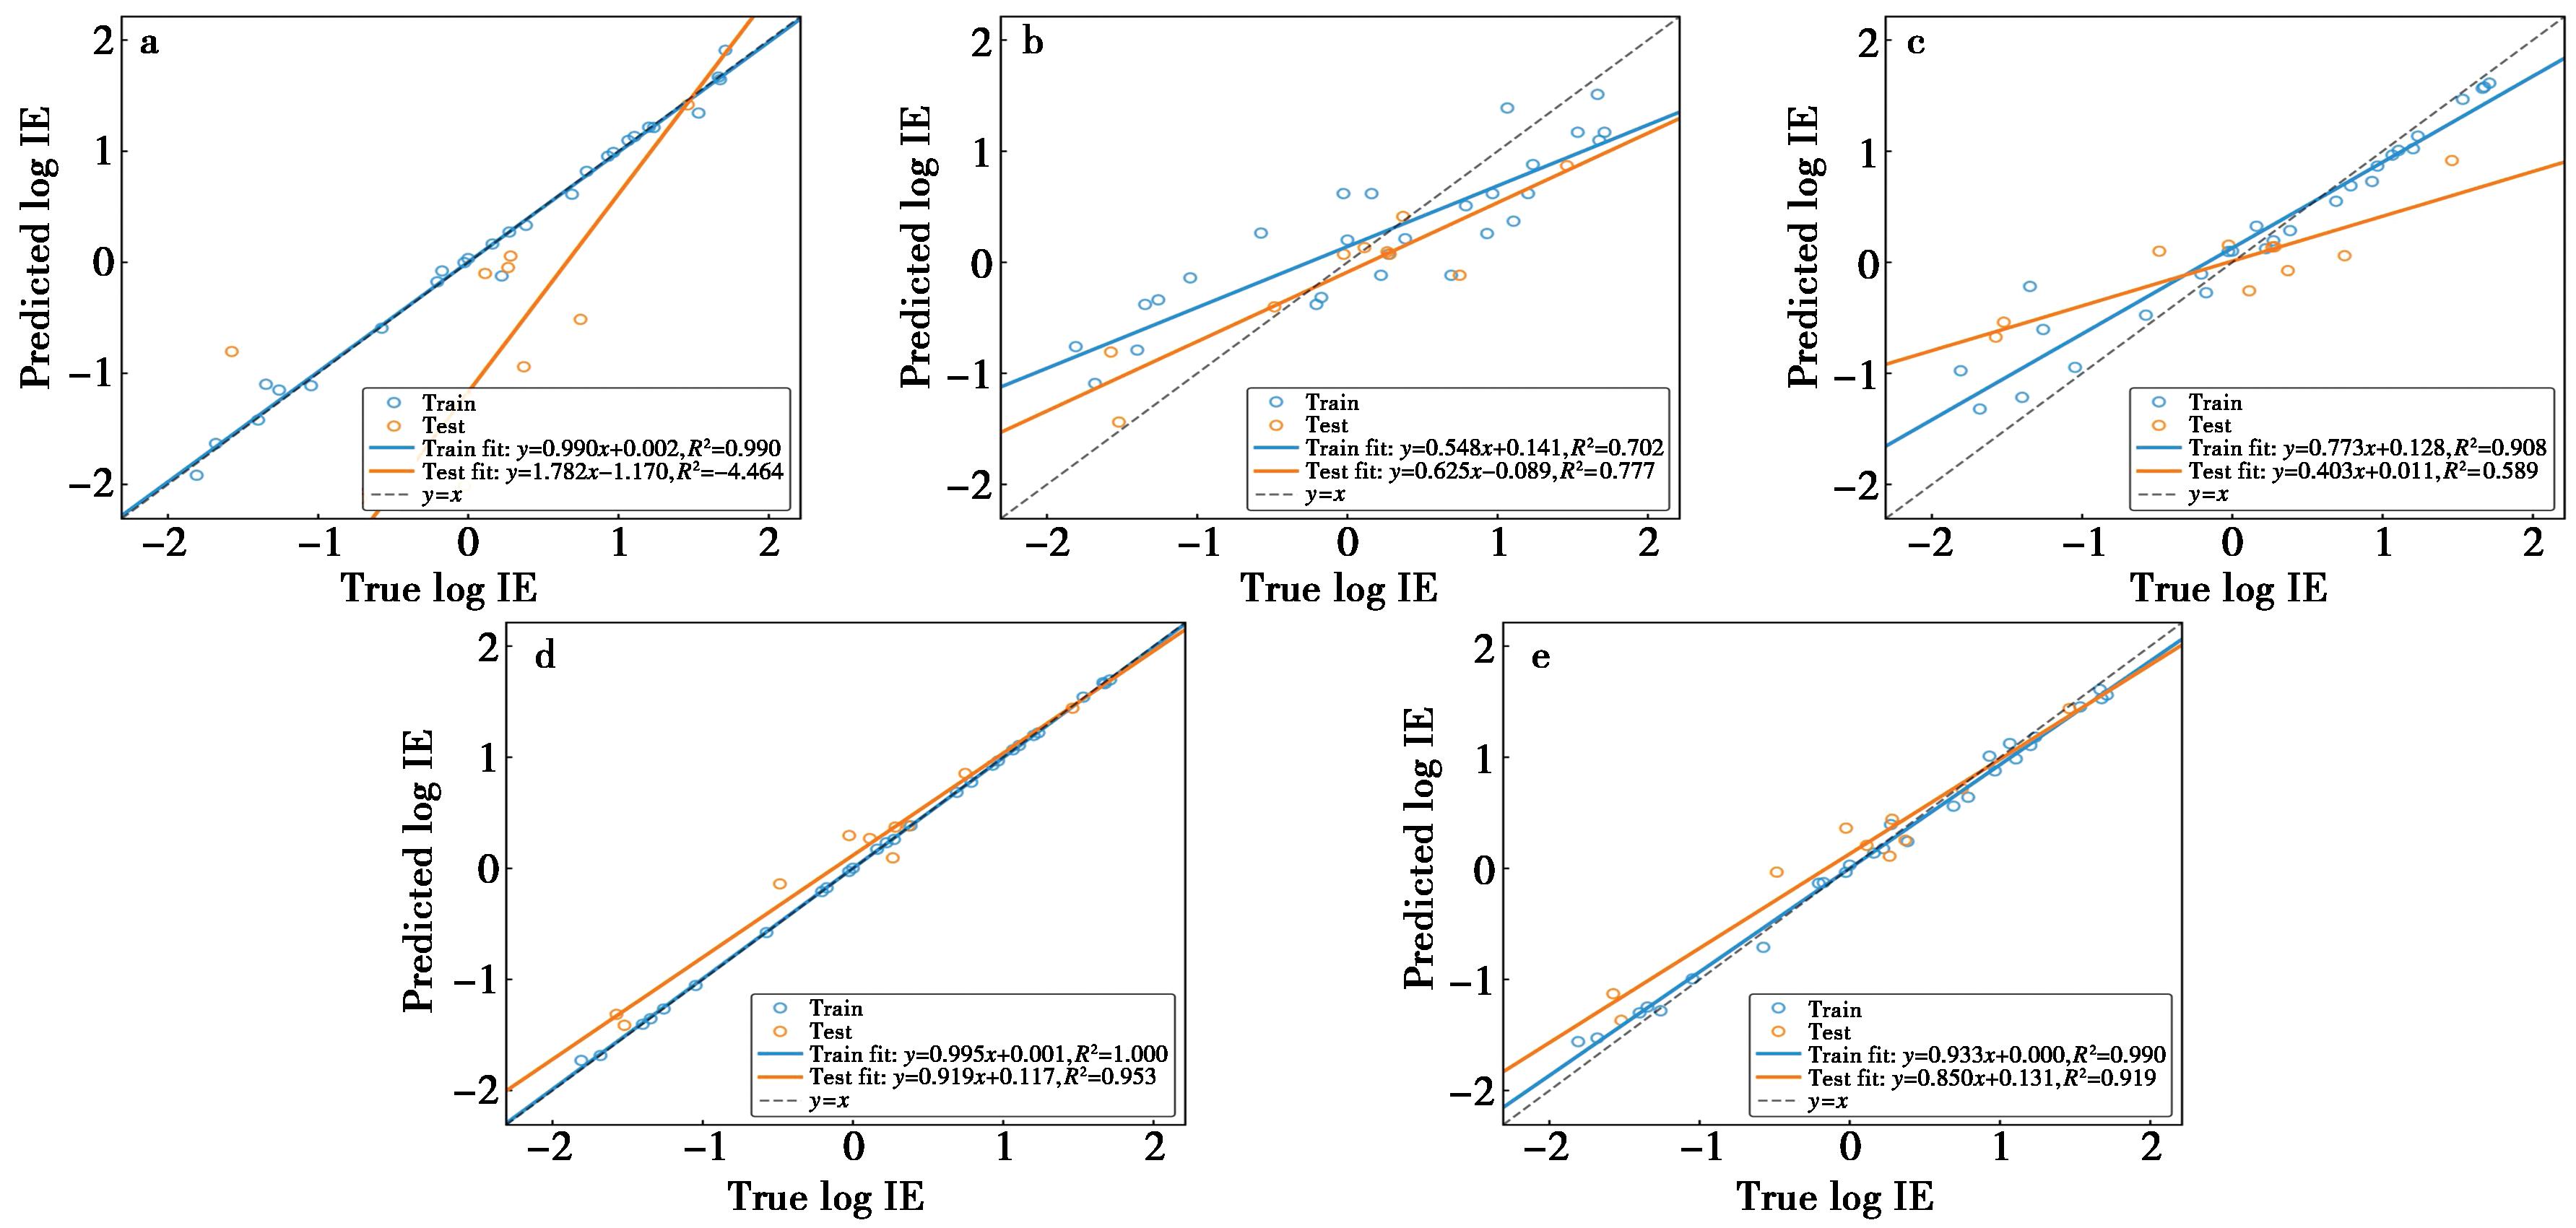
a.MLR;b.KNN;c.SVR;d.GBR;e.RF
图3 不同模型的拟合散点图
Fig.3 Fitting scatter plots of different models
结果表明,本研究中传统的线性模型MLR在测试集上的表现相对较弱(图3a),其测试集R2仅0.25。这表明化合物的分子描述符与电离效率之间存在复杂的非线性映射关系,线性拟合难以实现电离效率的精准预测。非线性模型中,相较于KNN和SVR,基于决策树的集成学习模型GBR与RF展现出了更好的模型预测性能,但GBR模型由于梯度提升机制不断拟合前序树的残差,在本研究中出现了过拟合现象。随机森林模型在本研究中展现了较高的预测精度(图3e),这可能得益于其内置的Bootstrap重抽样机制以及节点分裂时的特征随机选择,使其具备较强的预测精度和抗过拟合能力。RF模型训练集R2为0.97,RMSE为0.12,测试集R2为0.85,RMSE为0.22,展现出了最佳的综合预测性能。本研究采用五折交叉验证进一步比较不同机器学习算法的预测性能。五折交叉验证结果表明(图4),各模型在不同数据划分下的预测性能存在一定波动,这可能与本研究样本量较小有关。总体而言,RF在R2和RMSE两项指标上表现较优,具有较高的R2中位数和较低的RMSE中位数,说明其预测性能较好且相对稳定。GBR虽在部分划分中表现出较高预测精度,但其R2和RMSE分布范围较宽,并出现明显离群值,提示其对数据划分较为敏感。结合图3中其在训练集上几乎完全拟合而测试集性能下降的结果,说明GBR在当前小样本数据集上存在一定过拟合倾向。相比之下,RF在保持较高预测性能的同时波动较小,表现出更好的泛化稳定性,因此最终选择RF模型。
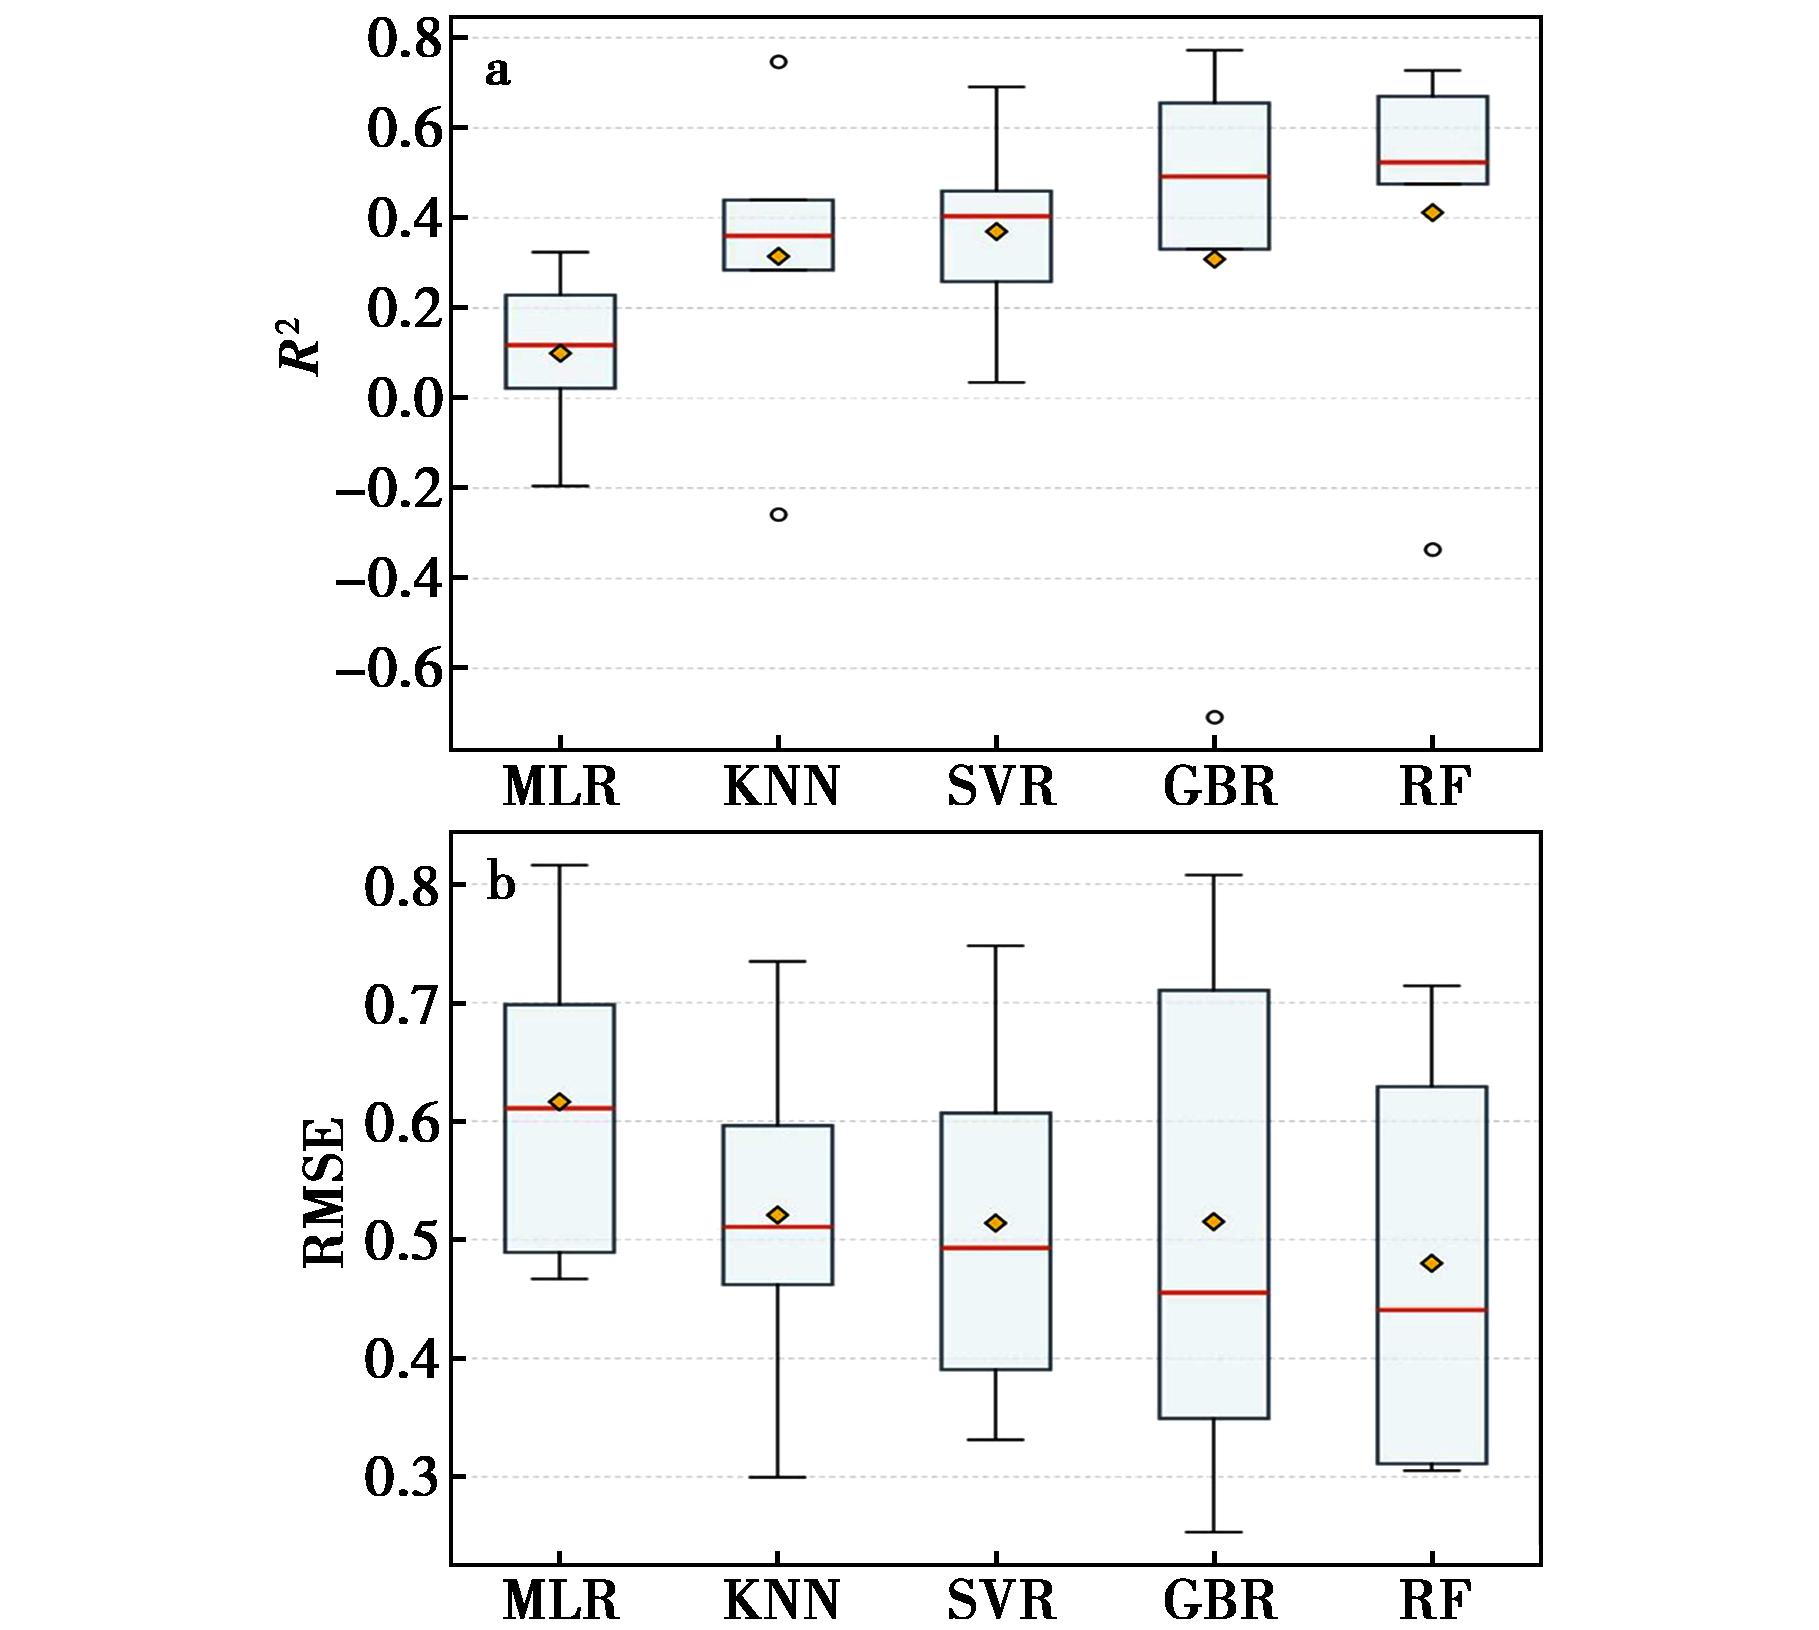
a.R2结果;b.RMSE结果
图4 五折交叉验证结果
Fig.4 Results of 5-fold cross-validation
2.3 模型SHAP分析与机理解释
本研究引入SHAP分析对最优的随机森林模型进行了全局解释(图5)。SHAP值量化了每个特征对单个预测的贡献。它为每个特征在特定样本上的重要性提供了更详细的解释,反映了特征在该样本中的边际贡献,可以看作是特征重要性的细化。
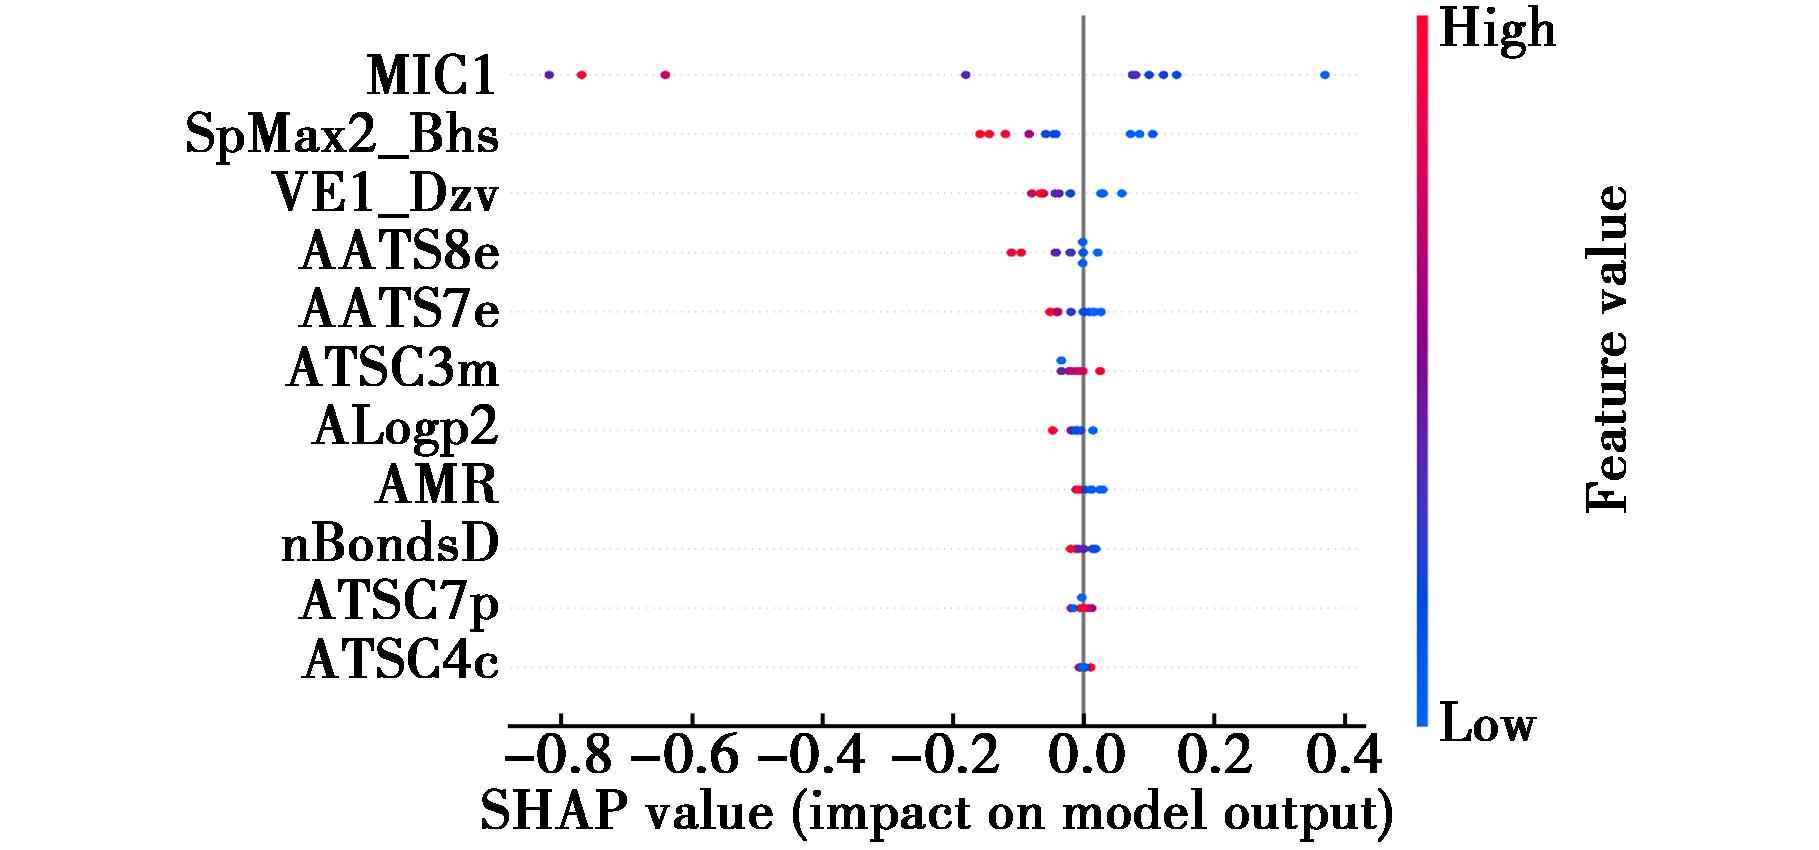
每个点代表一个化合物;颜色表示特征值高低,红色对应高值,蓝色对应低值
图5 SHAP值
Fig.5 SHAP values
分析结果表明,MIC1、SpMax2_Bhs和VE1_Dzv是主导电离效率变化的最关键变量,展现出了负向驱动效应,这些分子特征值升高会抑制电离效率。MIC1值的升高意味着分子具有高度复杂的分支或不对称的骨架结构。在电离过程中,高度不对称和复杂的空间结构会增加分子的空间位阻,阻碍其在带电液滴表面的有效排列与富集,从而使得分子更难被电离,对log IE产生负向驱动,这与特征重要性分析的结果一致。SpMax2_Bhs描述符反映了分子内部电负性和电拓扑状态的分布,该数值的增加通常指示分子骨架中引入了较强的吸电子基团或存在局部极性高度集中的区域,强吸电子效应会通过诱导或共轭作用降低分子内潜在质子化位点的电子云密度,显著削弱分子的质子亲和力,导致电离效率大幅受抑。VE1_Dzv是一个与分子三维空间拓扑和体积高度相关的参数,高VE1_Dzv值代表分子具有极大的范德华体积和空间体积膨胀,在质谱液滴的脱溶剂化阶段,体积较大分子可能具有较强的分子间色散作用,更难克服表面张力进入气相,从而具有较低的电离效率。
综上所述,SHAP分析结合分子结构特性表明,在本数据集中,具有低拓扑复杂度(低MIC1)、弱吸电子电荷分布(低SpMax2_Bhs)以及较小范德华体积(低VE1_Dzv)的分子,更容易获得较高的电离效率。
2.4 预测模型评价
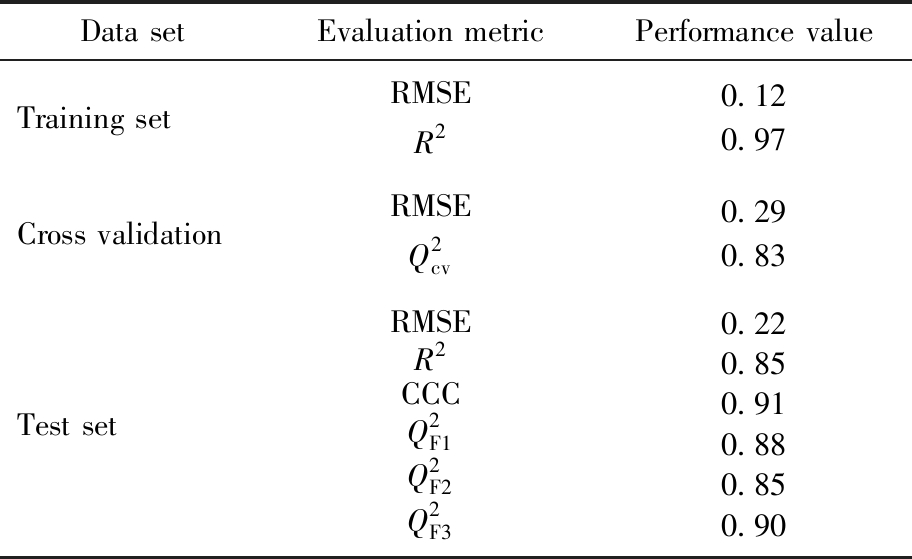
采用不同维度的指标对本研究建立的随机森林预测模型进行评价(表2)。在训练集内部进行十折交叉验证,评估模型的预测稳定性并排除过拟合风险,交叉验证系数 为0.83,表明模型具有较高的稳定性。
表2 模型评估
Tab.2 Model evaluation
Data setEvaluation metricPerformance valueTraining setRMSER20.120.97Cross validationRMSEQ2cv0.290.83Test setRMSER2CCCQ2F1Q2F2Q2F30.220.850.910.880.850.90
在测试集中,采用一致性相关系数(CCC)评价预测值与实验值之间的一致性,本研究CCC值为0.91,预测结果与实验值的一致性高。此外,本研究引入了外部预测方差解释指标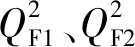 和
 分别为0.88、0.85和0.90,证明模型具有较强的泛化能力。结合上述内、外部验证指标,表明该模型具备对化合物log IE值进行高精度预测的能力。
2.5 预测误差分析
采用公式(3)计算电离效率预测误差,电离效率预测误差在1.01~2.69倍范围内,中位值为1.20倍,平均值为1.34倍,误差累积结果见图6a。误差最大的化合物是罗红霉素(ROM),其次是阿奇霉素(AZM)和替米考星(TIL),这3种化合物属于大环内酯类抗生素,大环内酯类抗生素具有高度灵活的3D大环结构,具有更大的范德华体积和较为复杂的空间拓扑不对称性,导致其真实的电离效率易受微观实验条件的干扰而产生波动,且该结构特征可能处于本模型训练集的适用域边缘,对于具有较大体积和高拓扑复杂度的分子,需进一步扩充特定化学空间以扩展模型的适用域。与文献的IE或响应因子(RF)预测误差相比[7,19,22,23],本研究所建立的小样本预测模型具有相当的或更好的预测精度。
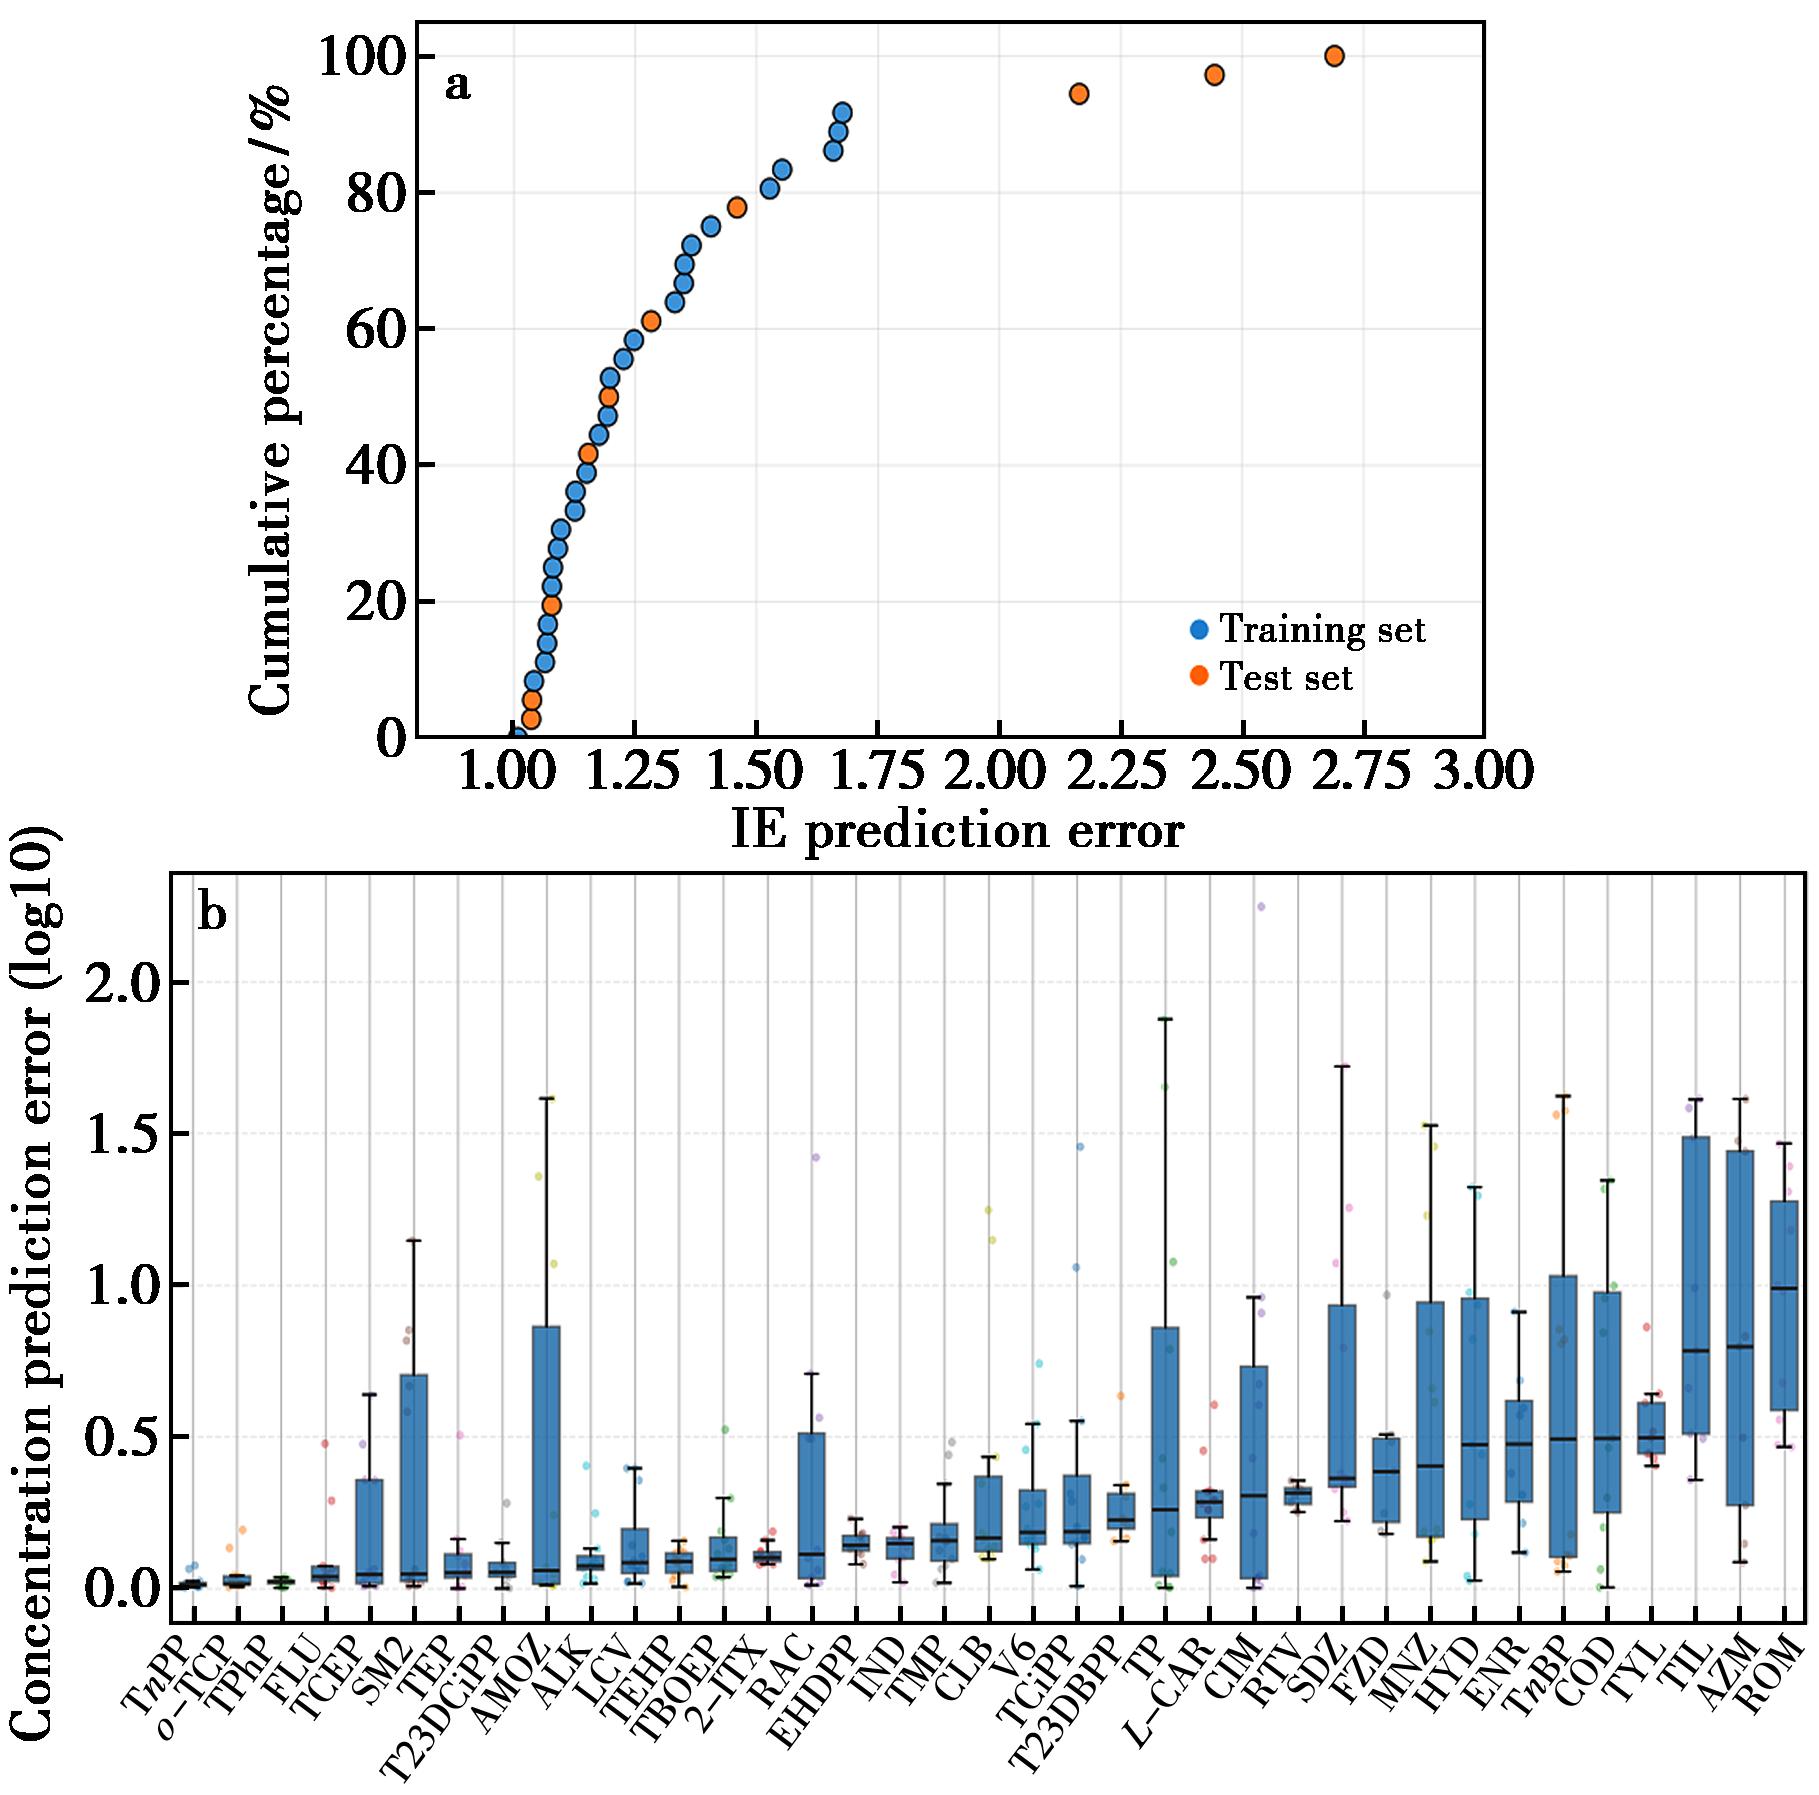
a.电离效率预测误差;b.浓度预测误差(其中纵坐标y为浓度预测误差倍数经log 10转换后的数值,其对应的实际预测误差倍数为10y)
图6 预测误差
Fig.6 Prediction errors
进一步比较标准曲线各浓度标准溶液中不同化合物浓度预测误差,如图6b所示,浓度预测误差中位值为1.45倍,平均值为4.78倍。图6b中浓度预测误差的平均值明显高于中位值,结果表明部分化合物在部分浓度标准溶液中存在较大的预测误差。进一步分析发现,高预测误差主要集中于电离效率预测误差较大的ROM、AZM和TIL。此外,由于电离效效率和浓度的换算未纳入截距项(公式(2)),部分化合物在低浓度水平下受截距影响,出现较高的浓度预测误差。
2.6 实际水样分析
本研究将模型应用于实际环境水样中恩诺沙星(Enrofloxacin,ENR)的半定量分析。实际环境水样中的恩诺沙星采用标准曲线法进行准确定量,并将预测模型半定量分析结果与准确定量结果进行比较(表3),5个环境水样中恩诺沙星浓度预测误差倍数在2.05~5.23倍之间,平均值为2.88倍,中位数为2.26倍。实际水样的应用中,Aalizadeh等[18]研究的海水中化合物的浓度预测误差在1.0~23.6倍范围内,Palm等[23]研究的超纯水和自来水中化合物的浓度预测误差平均值分别为6.0倍和5.5倍,本研究环境水样中恩诺沙星浓度预测误差倍数在2.05~5.23倍之间,误差较小,但目前仅限于恩诺沙星,值得进一步拓展。整体来看,将该模型应用于实际水样时,该化合物的预测误差在可接受的范围内,该模型具有较好的应用前景。
表3 水样中恩诺沙星预测结果与标准曲线定量结果比较
Tab.3 Comparison of quantitative results between prediction model and calibration curve of ENR in water samples
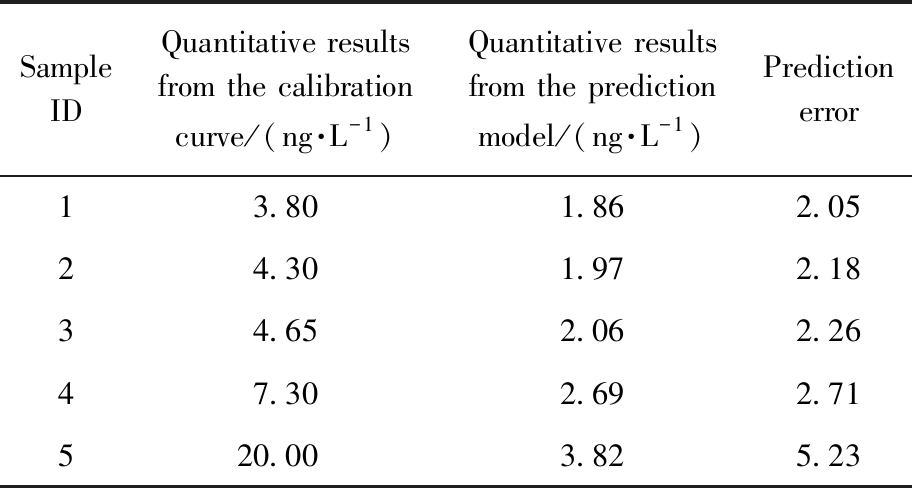
Sample IDQuantitative results from the calibration curve/(ng·L-1)Quantitative results from the prediction model/(ng·L-1)Prediction error13.801.862.0524.301.972.1834.652.062.2647.302.692.71520.003.825.23
3 结论
本文提出并验证了一种基于机器学习的电离效率预测定量策略,建立的随机森林预测模型不仅能够高精度地预测化合物的电离效率,还能通过可解释性分析,从分子层面阐明结构与电离效率之间的影响机制,研究表明,分子的拓扑复杂性、电负性分布以及空间体积是对电离过程产生抑制作用的重要因素。本研究建立的预测模型为非靶向分析中无参考标准化合物的定量提供了方法支撑,也为质谱电离效率机制的探索提供了新的视角。需要指出的是,本研究所建立的电离效率预测模型是基于ESI+模式构建的,因此,该模型的适用范围主要集中于在ESI+模式下易于质子化的小分子有机物,未来工作可建立针对不同离子化模式的预测模型,并通过持续扩充数据规模与化合物结构多样性,提升模型的泛化能力与应用场景。
[1]Manz K E,Feerick A,Braun J M,Feng Y L,Hall A,Koelmel J,Manzano C,Newton S R,Pennell K D,Place B J,Godri P K J,Prasse C,Young J A.J.Expo.Sci.Environ.Epidemiol.,2023,33(4):524-536.
[2]Liu Z Q,Huang Y L,Fu B F.Phys.Test.Chem.Anal.B,2024,60(12):1209-1215.刘子琪,黄元礼,付步芳.理化检验-化学分册,2024,60(12):1209-1215.
[3]Wang X Y,Zhang F,Wu X D,Ji Z Q,Shi Y L,Cai Y Q.J.Anal.Test.,2025,9(4):457-481.
[4]Cui D N,Cox J,Mejias E,Ng B,Gardinali P,Bagner D M,Quinete N.J.Expo.Sci.Environ.Epidemiol.,2023,33(4):589-601.
[5]Ou H,Liu Y J,Huang Y Y,Zhou Z M,Liu H,Xie D P,Jia C J,Liu W Q.J.Instrum.Anal.2025,44(8):1568-1576.区晖,刘永杰,黄雅阳,周志敏,刘鹤,谢丹平,贾成俊,刘威奇.分析测试学报,2025,44(8):1568-1576.
[6]Malm L,Palm E,Souihi A,Plassmann M,Liigand J,Kruve A.Molecules,2021,26(12):3524.
[7]Liigand J,Wang T T,Kellogg J,Smedsgaard J,Cech N,Kruve A.Sci.Rep.,2020,10(1):5808.
[8]Wang T T,Liigand J,Frandsen H L,Smedsgaard J,Kruve A.Food Chem.,2020,318:126460.
[9]He J H,Hua K,Gao K,Wei W,Lu L P.J.Instrum.Anal.,2025,44(8):1585-1593.何佳豪,华凯,高珂,魏巍,鲁理平.分析测试学报,2025,44(8):1585-1593.
[10]Wei J T,Xiao X J,Li K,Song Y Y,Huang S K,Cai Z W,Liu Z G.Talanta,2021,233:122464.
[11]Shan Q Y,Cao G,Cai H,Cong X D,Cai B C.J.Chromatogr.A,2012,1264:13-21.
[12]Katritzky A R,Ignatchenko E S,Barcock R A,Lobanov V S,Karelson M.Anal.Chem.,1994,66(11):1799-1807.
[13]B czek T,Bodzioch K,Michalska E,Kaliszan R.Chromatographia,2008,68(3/4):161-166.
[14]Cao D P,Schwichtenberg T,Duan C Y,Xue L,Muensterman D,Field J.J.Am.Soc.Mass Spectrom.,2023,34(5):939-947.
[15]Evans R L,Bryant D J,Voliotis A,Hu D W,Wu H H,Syafira S A,Oghama O E,Mcfiggans G,Hamilton J F,Rickard A R.Anal.Chem.,2024,96(46):18349-18358.
[16]Kruve A,Kaupmees K,Liigand J,Leito I.Anal.Chem.,2014,86(10):4822-4830.
[17]Liigand P,Liigand J,Cuyckens F,Vreeken R J,Kruve A.Anal.Chim.Acta,2018,1032:68-74.
[18]Aalizadeh R,Nikolopoulou V,Alygizakis N,Slobodnik J,Thomaidis N S.Anal.Bioanal.Chem.,2022,414(25):7435-7450.
[19]Feng Y L,Feng J,Baesu A,Martinez V,Li Y.Anal.Chim.Acta,2025,1364:344215.
[20]Gramatica P.Computational Toxicology.Totowa:Humana Press,2012:499-526.
[21]R cz A,Bajusz D,Héberger K.Mol.Inf.,2019,38:1800154.
[22]Abrahamsson D,Park J S,Singh R R,Sirota M,Woodruff T J.J.Chem.Inf.Model.,2020,60(6):2718-2727.
[23]Palm E,Kruve A.Molecules,2022,27(3):1013.